▶ Cette vidéo présente la première version du Conclave, dans laquelle quatre LLM interviennent successivement (7mn 28)
Dans le projet suivant on raffine les processus en mettant l'auteur A et l'auteur B en parallèle sur la même carte RTX
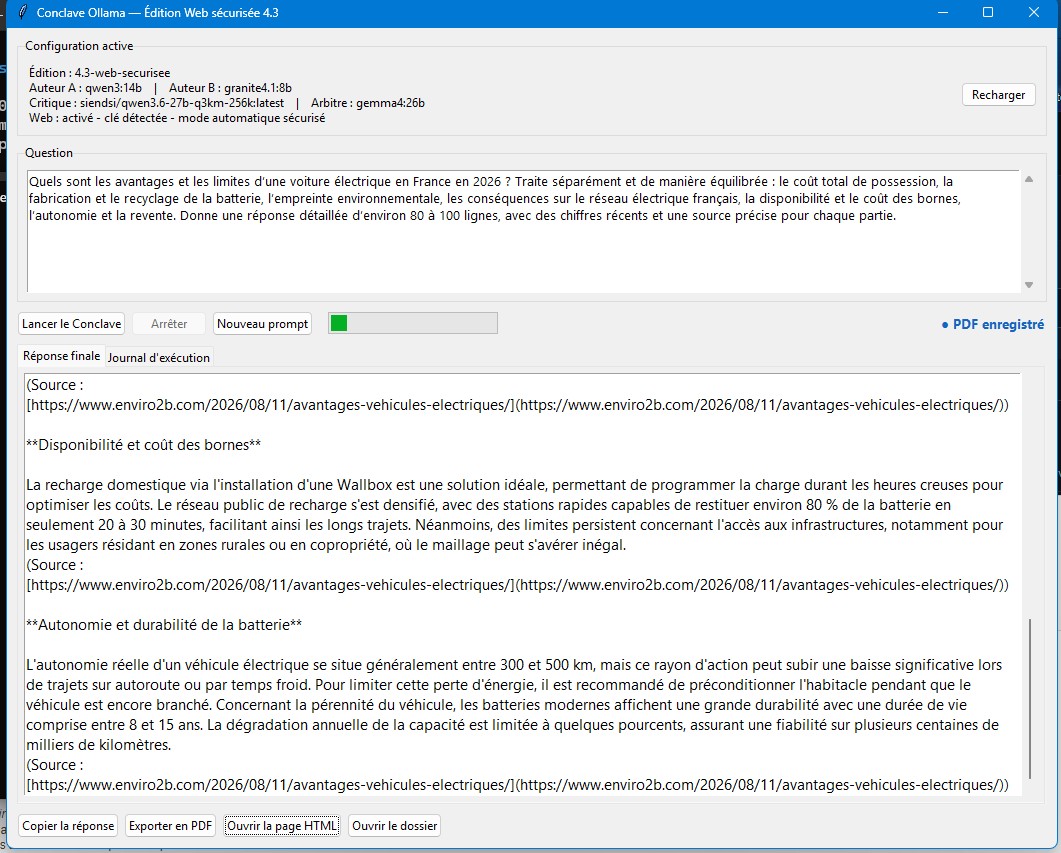
Conclave V4 : Arbitrage de 4 LLM en local avec Ollama et Tkinter
Introduction :
Ici 4 LLM collaborent localement. Seuls les auteurs A et B calculent en parallèle ; le critique intervient ensuite, puis l’arbitre produit la réponse finale.
Système local d’arbitrage entre 4 modèles de langage (Qwen3:14b, granite4.1:8b, siendsi/qwen3.6-27b-q3km-256k:latest, Gemma4:26b) pour générer des réponses synthétisées).
Développé avec Ollama (service Windows) et une interface Tkinter..
- Architecture :
- 2 LLM exécutés en parallèle via Ollama. qwen3:14b et granite4.1:8b (auteurs A et B)
- Script Python : num_predict=16384, timeout=600, gestion des erreurs intégrée.
- 1 LLM sert de critique >> siendsi/qwen3.6-27b-q3km-256k:latest
- 1 LLM finalise la réponse >> Gemma4:26b
- Fonctionnement :
- Temps de réponse moyen : ~1m30. ou 3 à 5 mn pour une analyse exigeante
- Exemple de prompt testé : "Quels sont les avantages et inconvénients des énergies renouvelables ?
Réponse en 50 lignes environ" - Résultat : Synthèse automatique des 4 réponses (ex. : suppression des redondances, mise en avant des points communs).
Une recherche sur le web s'active toute seule pour les questions d'actualité
- Environnement technique :
- Matériel : RTX 5070 Ti (16 Go VRAM), 32 Go RAM DDR5
- Logiciels : Ollama (service Windows), Python 3.x, Tkinter.
- Affichage dans une interface GUI :
- Export PDF des réponses (optionnel).
- Ajout de boutons prédéfinis dans la GUI (ex. : "Relancer", "Effacer").